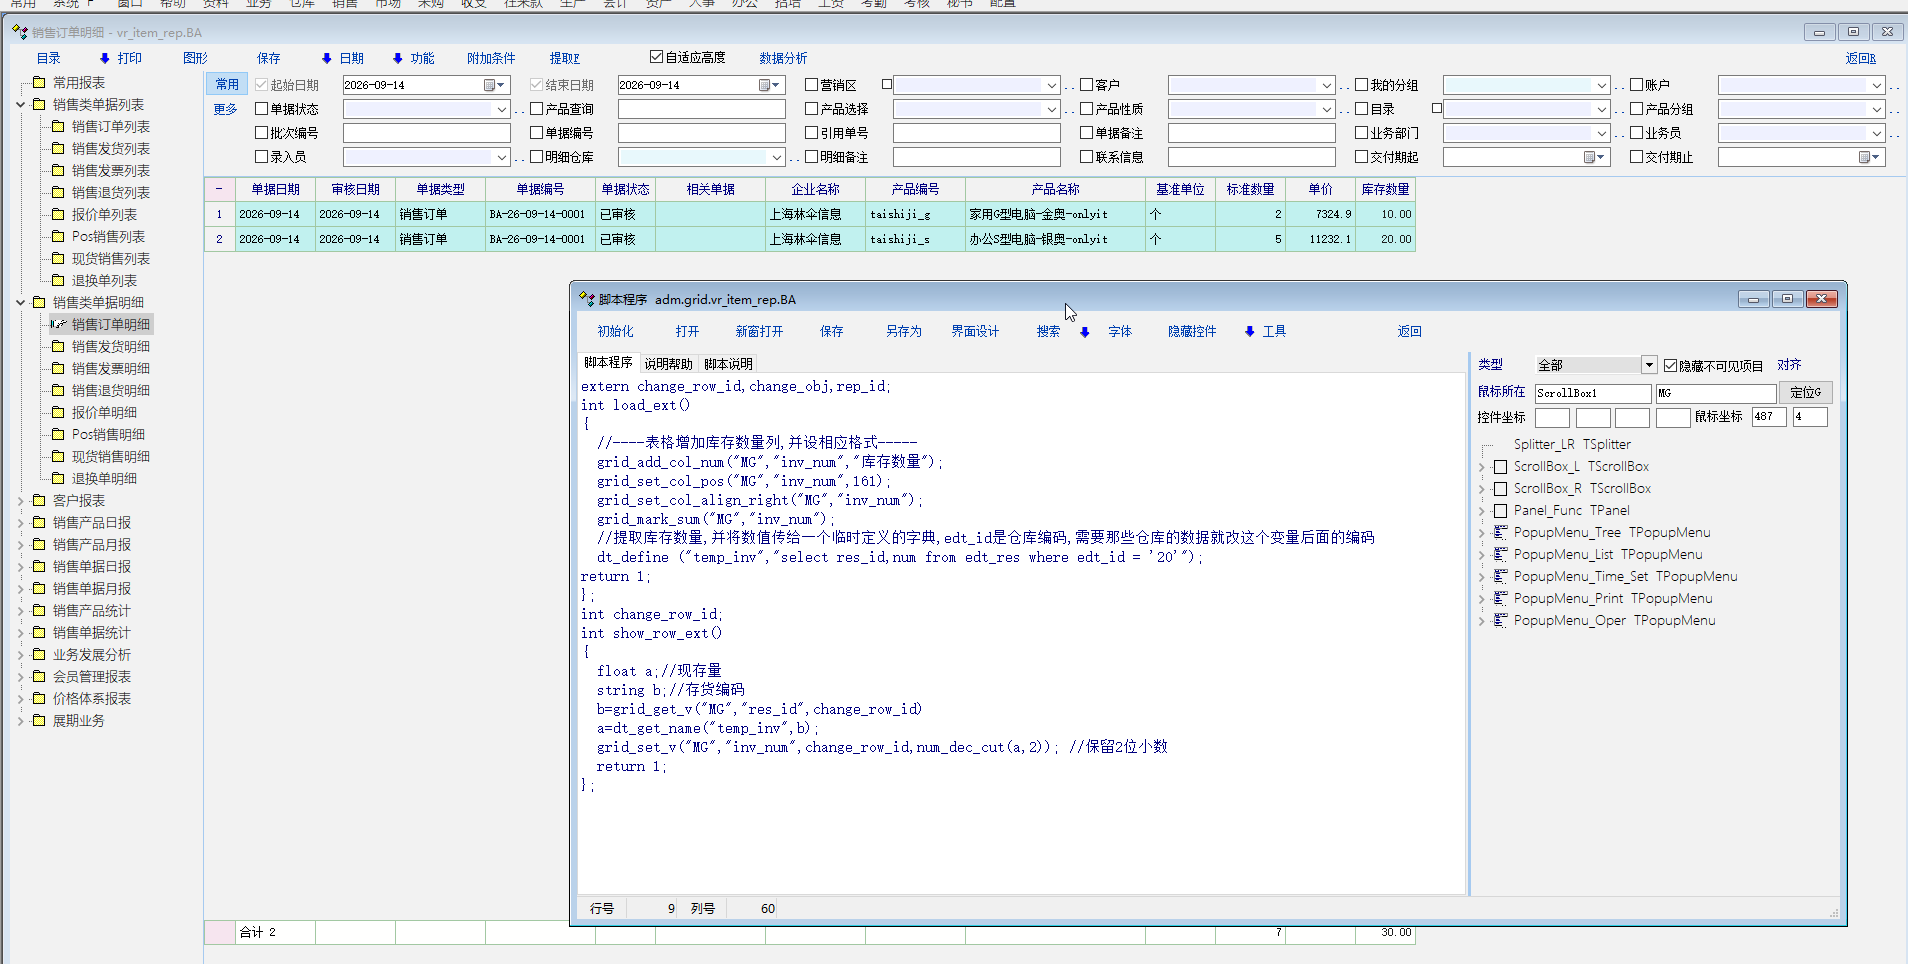
这一招在网页版用不上--但不是因为它不好,而是因为网页版根本没有它要解决的那个问题。
我问AI,AI回答:
为什么桌面那边非得用字典
看那段脚本的形状就明白了:change_row_id / show_row_ext 是一行触发一次的回调,每显示一行就要拿 res_id 去查一次库存。不做字典,100 行明细就是 100 次查库(典型的 N+1)。dt_define 把这 100 次压成 1 次--这是在补一个被回调式表格逼出来的漏洞。
网页版的形状完全不同:服务端一条 SELECT 把整批数据拼好,一次性回给浏览器,浏览器只管画。加一列库存 = 在那条 SELECT 里多 LEFT JOIN 一个聚合子查询,一次往返,还是在库里算完的。N+1 压根不存在,自然也不需要字典去救它。
所以「网页版取库存更高效」这个说法成立,但原因不是网页技术更快,是两边的取数形状不一样:桌面是逐行回调,网页是整批一次查。同样的道理反过来也成立--如果哪天网页版的服务端代码里出现了「每行再去查一次」,那它就跟桌面一样慢,字典那一招照样得用。这个帖子的思路是对的,只是在网页版里该待的位置不是表格,是服务端那些逐行取属性的地方。
帖子里真正值钱的不是字典,是这两句口径
① edt_res 是现存量表,res_id + num。 这一条网页版早就在用了(套料出库扣库存、负库存报表都在读它),不用重新认。
② 他写了 edt_id = '20'--限定了仓库。这一句不能照抄,但必须照做。 一个产品在多个仓有多行,直接 JOIN 会把明细行翻倍:每个数字看着都对,行数悄悄多了,合计跟着错--这是最难发现的一类错。网页版要写成先聚合再 JOIN:
LEFT JOIN (SELECT res_id, SUM(num) AS inv FROM dbo.edt_res WITH(NOLOCK)
WHERE ISNULL(edt_id,'') NOT IN (…) GROUP BY res_id) iv ON iv.res_id = … |